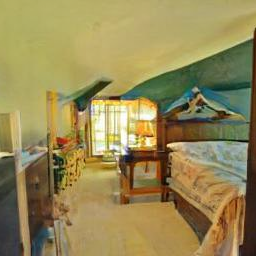
Sengen fyller høyre side av bildet. På den ligger et lyst, mønstret teppe, og innerst i rommet lyser et vindu. Det er åpenbart et soverom, selv om formene over sengen flyter sammen.
Vi laget bildet med en ferdigtrent diffusjonsmodell. Metoden, DDPM, ble beskrevet av Jonathan Ho, Ajay Jain og Pieter Abbeel i 2020. Modellen var trent på soveromsbilder, men vi ga den ingen beskrivelse av rommet den skulle lage. Verken sengen, teppet eller vinduet var bestilt. vår kjøring.
Beregningen begynte med tilfeldige tall som framstår som støy. Ingen seng lå skjult bak prikkene og ventet på å bli avdekket.
For i treningen begynner vi med bilder som allerede har et synlig innhold. Små, tilfeldige endringer gjør strukturen stadig vanskeligere å skille ut, helt til bildene nærmer seg ren støy. Samtidig trenes en annen beregning til å gå tilbake mot bilder med struktur. Det var denne grunnideen Jascha Sohl-Dickstein og kolleger beskrev i 2015. Navnet diffusjon kommer fra prosessen som sprer og gradvis visker ut informasjonen.
Ho og kollegene ga treningen et bestemt mål. Programmet velger et bilde, et støynivå og tilfeldig støy. Det demper bildets fargeverdier og blander dem med støyen, før et nevralt nettverk får blandingen og beskjed om hvor høyt støynivået er. Nettverket skal anslå støyen som er tilført. Her har treningen noe å måle mot: Programmet vet jo hvilken støy det nettopp la til. Forskjellen mellom den og anslaget brukes til å justere nettverkets vekter, tallene som styrer beregningen. Så gjentas arbeidet med nye kombinasjoner.
Fasiten blir altså laget sammen med treningsoppgaven. Ingen trenger å sitte med hvert forstyrret bilde og peke ut prikkene maskinen skal fjerne. Det betyr likevel ikke at jobben er enkel. En lys flekk kan høre til en pute, eller være en tilfeldig endring av fargeverdiene. Å få vite hvor mye støy som er lagt til, forteller ikke nettverket hvilke deler av blandingen den ligger i. Jo mindre av bildet som er bevart, desto flere motiver kan passe. Nettverket må lære å bruke mønstre i bildematerialet til å anslå støyen; det får ingen regel som entydig finner tilbake til ethvert originalbilde.
Det samme fotografiet kan derfor brukes om og om igjen, med ulike mengder støy. Ved et lavt nivå er motivet allerede synlig. Ved et høyt nivå er langt mer usikkert, og oppgaven er en annen. Den samme modellen trenes for hele spennet.
Først etter denne treningen kommer forsøket vårt. Nå finnes det ikke noe originalbilde som skal reddes.
Programmet trekker tilfeldige verdier og gir dem til modellen. En beregnet del av modellens støyanslag trekkes fra verdiene, og resten skaleres opp. Slik får programmet et foreløpig anslag på et bilde uten støy. Det anslaget blandes med verdiene som gikk inn i steget, og programmet legger til ny tilfeldig støy. Vi er altså ikke ferdige med støyen fordi vi har begynt å fjerne den. Genereringsmetoden og kontrollen av kjøringen.
Resultatet sendes gjennom den samme modellen igjen, denne gangen med beskjed om et lavere støynivå. Slik fortsetter beregningen gjennom tusen trinn. De trente vektene ligger fast hele veien, som i den publiserte DDPM-metoden. Først i det siste steget lar programmet være å tilføre ny støy. kjøregrunnlaget.
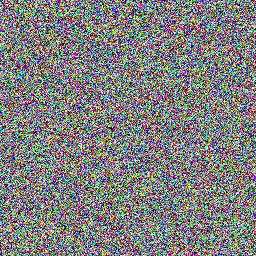
0
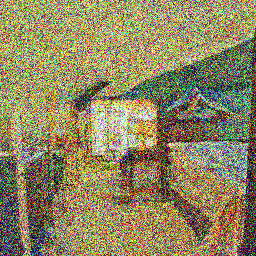
800
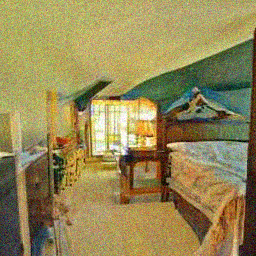
960
1000
DDPM · generert 9. september 2026 · Kjøredata
Etter 800 trinn kan vinduet og den lyse sengen skimtes gjennom prikkene. Ved 960 er rommet langt tydeligere. De siste stegene fjerner mer av kornene, men gjør ikke alle formene over sengen forståelige. De lagrede mellomstadiene.
De tilfeldige tallene gjør at vi kan få forskjellige bilder fra den samme modellen. Vektene gir beregningen en retning som støy alene ikke har, mens nye tilfeldige tall kan sende den frem mot et annet rom. Slik trekkes nye eksempler fra det modellen har lært om bilder.
Det utelukker ikke at et resultat kan ligne et fotografi fra treningen. Hvor nært akkurat dette soverommet ligger bildene i treningsmaterialet, måtte vi ha undersøkt ved å sammenligne dem. Det har vi ikke gjort.
Men teppet var i alle fall ikke lyst fordi noen hadde bedt om det. For å kunne bestille en bestemt farge trenger vi en forbindelse mellom ord og bilder. Den manglet i modellen vi brukte.
En slik forbindelse kan læres med bilde–tekst-par. I CLIP får bildet og teksten hvert sitt nettverk, som lager tallrepresentasjoner det går an å sammenligne. Treningen gjør representasjonene for parene som hører sammen, likere, og skiller dem fra de andre paringene i gruppen. Etterpå kan modellen gi en skår for hvor godt et bilde passer med en tekst. Det er nyttig om vi vil vurdere forbindelsen mellom dem, men det kommer ingen bildepiksler ut av skåren. CLIP er ikke en bildegenerator.
Da må ordene få påvirke selve genereringen. Forskerne bak GLIDE gjorde dette med en annen diffusjonsmodell, trent på forstyrrede bilder og tilhørende tekster. Beskrivelsen ble omgjort til tallrepresentasjoner som fikk påvirke modellens beregninger. Dermed avhang anslaget av neste tilstand også av hva teksten sa. Nå hadde bestillingen kommet inn i arbeidet med å lage bildet.
Likevel kan ikke ordene avgjøre alt. Ber vi om et lyst teppe, har vi ennå ikke sagt hvordan det skal folde seg over sengekanten, hvor vinduet skal stå eller hva som skal henge på veggen. Bildet må ha flere detaljer enn bestillingen. Teksten gir den gjentatte beregningen en mer bestemt retning, uten å beskrive hvert punkt i resultatet.
Vårt soverom ble laget uten denne forbindelsen til ordene. Fotografier hadde gitt treningen materiale; forsøket begynte med tilfeldige tall og endte med et vindu, en seng og noen former som ikke helt lar seg plassere. Bildet har fått fotografiets form. Det dokumenterer ikke et rom noen har besøkt.